예제 문서로 처음부터 끝까지
키트에 든 예제 문서(가상 회사 「한별정밀」 · 전부 지어낸 내용)로 한 번 끝까지 해 보고, 그 폴더 안의 파일만 우리 회사 문서로 바꾸면 끝이에요. 단계마다 화면 그림과 실제 출력, 그리고 「확인」 줄이 있어요 — 확인 줄이 맞으면 다음으로 넘어가면 돼요. 전부 해도 1시간이면 충분해요.
- 시작 전 체크 (10분)
- API 키 만들기
- 키트 내려받기 · 예제 폴더 살펴보기
- 설치 (1회)
- init — 기본 모델 받기 (1회)
- parse — 예제 문서 읽기
- train — 사내에서 학습
- pack — 올릴 패키지 만들기
- upload — Tunia에 올리고 확인
- 이제 우리 문서로 바꾸기
- 폐쇄망 · 더 정확하게 · 자주 겪는 문제
- 공공기관은 이렇게 — 공공 모드(N2SF C·S·O)
시작 전 체크 (10분)
- Tunia 계정 — tunia.ai 로그인 (구글 계정 또는 이메일)
- 파이썬 3.10 이상이 있는 PC 또는 서버 (리눅스·맥·윈도우는 WSL 권장) — 터미널에서 python3 --version
- 디스크 3GB · 인터넷 (폐쇄망이면 10장)
- GPU는 없어도 돼요 — 예제 문서 48건은 CPU로 10~20분, GPU로 2~3분
API 키 만들기 — 콘솔
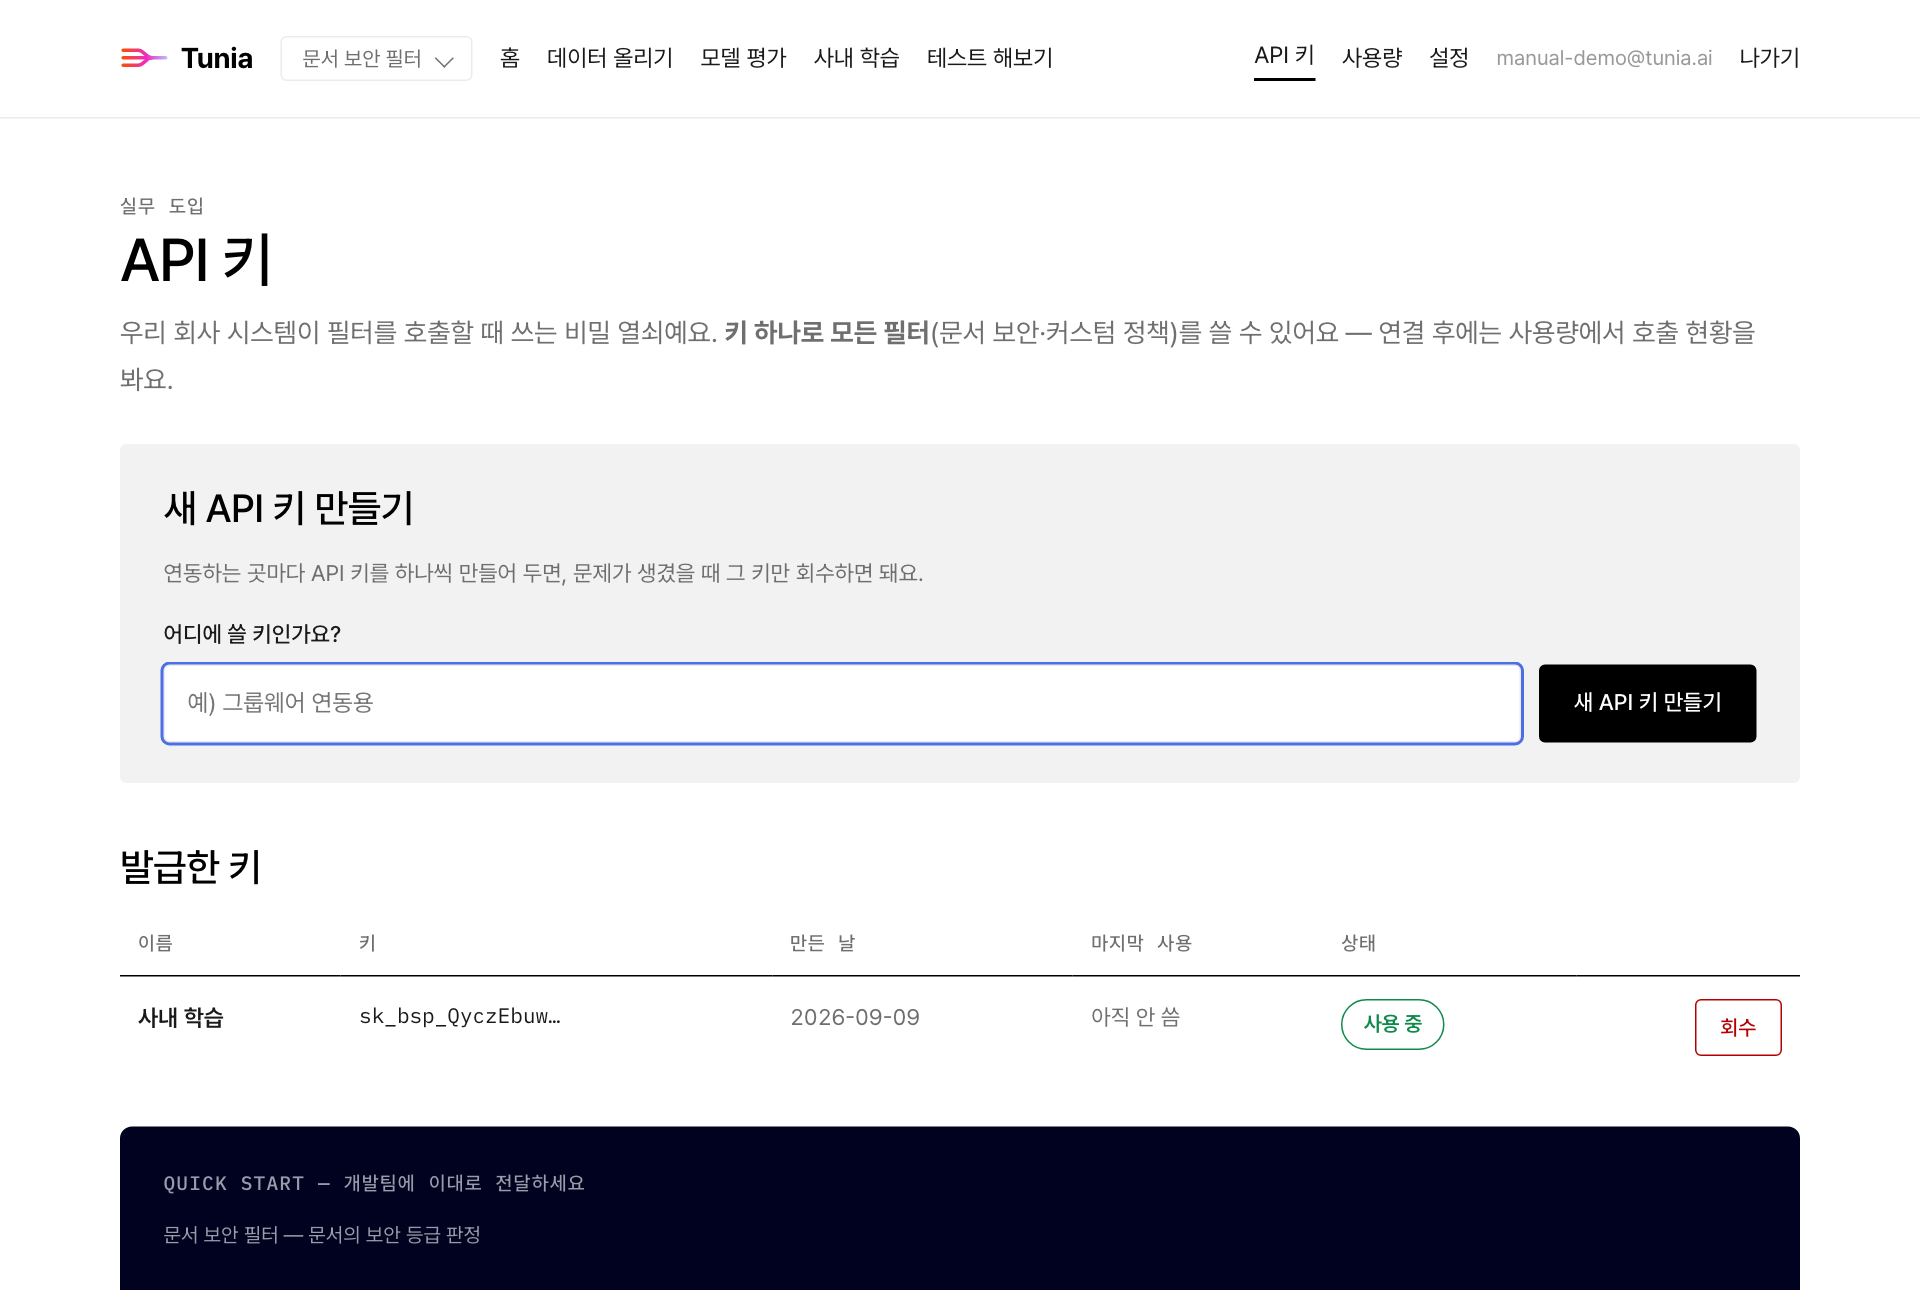
키트가 기본 모델을 받고 결과를 올릴 때 쓰는 열쇠예요. 상단 메뉴 API 키 → 「어디에 쓸 키인가요?」에 사내 학습 처럼 적고 새 API 키 만들기.
키트 내려받기 · 예제 폴더 살펴보기
상단 메뉴 사내 학습 → 「1 · 키트 받기」의 키트 내려받기 (zip). 기본 모델 번들은 다음 단계의 init 이 알아서 받으니 지금은 키트만 받아요.
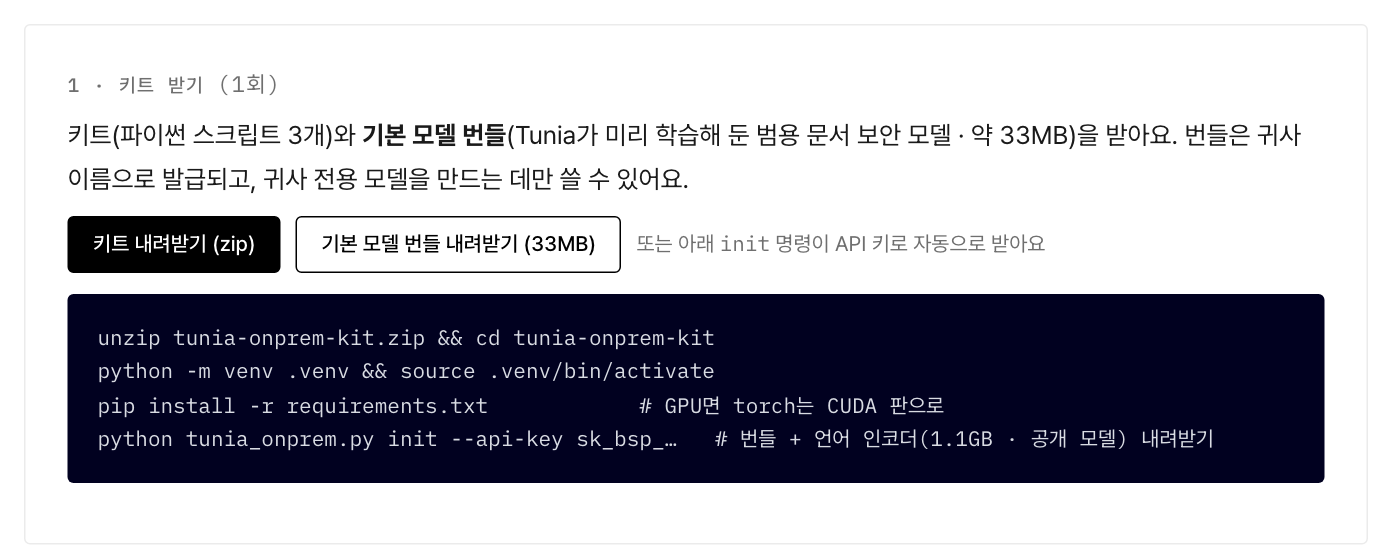
내려받은 tunia-onprem-kit.zip 을 작업할 폴더에 풀면 이렇게 생겼어요.
tunia-onprem-kit/
  tunia_onprem.py                 ← 명령을 실행하는 스크립트 (이것만 쓰면 돼요)
  train_job.py · ksdfm_mini.py    ← 학습 코드 (건드릴 필요 없음)
  requirements.txt · Dockerfile · README.md · MANUAL.md
  예제문서/
    README.txt                    ← 폴더 설명
    학습문서/
      공개/  내부/  기밀/  제한/  영업비밀/  특급/    ← 폴더 이름이 곧 정답 등급
      등급모름/                                   ← 등급을 모르면 여기에 (자동 라벨)
    시험문제지/
      공개/  내부/  기밀/  제한/  영업비밀/         ← 학습에 안 쓰고 채점에만
    labels.csv.예시                ← 폴더 대신 표로 등급을 줄 때의 예
설치 (터미널 · 1회)
cd tunia-onprem-kit
python3 -m venv .venv
source .venv/bin/activate            # 윈도우(PowerShell): .venv\Scripts\Activate.ps1
pip install -r requirements.txt      # 5~10분 — torch가 커서 정상이에요
                                     # GPU가 있으면 pytorch.org 의 CUDA 판 torch 설치 명령을 먼저 실행
init — 기본 모델 번들·언어 인코더 받기 (1회)
Tunia가 대규모 문서로 미리 학습해 둔 기본 모델(귀사 이름으로 발급 · 귀사 전용 모델 학습 용도)과 공개 언어 인코더를 받아요.
python tunia_onprem.py init --api-key sk_bsp_여기에_1장에서_복사한_키
작업 폴더: /home/me/tunia-onprem-kit
  기본 모델 번들 10.3/10.3 MB
✓ 기본 모델 번들 준비 완료 → /home/me/tunia-onprem-kit/base
  인코더 intfloat/multilingual-e5-base 확인 중 (첫 번째는 약 1.1GB 내려받아요)…
✓ 인코더 준비 완료 → /home/me/tunia-onprem-kit/hf
✓ 설정 저장 → /home/me/tunia-onprem-kit/tunia.json (API 키가 들어 있어요 · 권한 600)
parse — 예제 문서 읽기
python tunia_onprem.py parse ./예제문서/학습문서
python tunia_onprem.py parse ./예제문서/시험문제지 --test
✓ 문서 43/43건 → data/train.jsonl  (약 43쪽)
  직접 단 등급 43건 → 학습 때 정답으로 우선 써요 (CLASSIFIED 3 · CONFIDENTIAL 9 · INTERNAL 9 · PUBLIC 7 · RESTRICTED 7 · TRADE_SECRET 8)
  ※ 이 파일에는 문서 원문이 들어 있어요 — 회사 밖으로 보내지 마세요. 학습이 끝나면 지워도 돼요.
무슨 일이 일어났나: 폴더 이름(공개·내부·기밀·제한·영업비밀·특급)을 읽어 문서마다 정답 등급을 달았어요. 「등급모름」처럼 등급 이름이 아닌 폴더의 문서는 학습 때 자동으로 라벨을 달아요. 만들어진 파일은 문서 원문이 들어 있으니 회사 안에만 두세요.
train — 사내에서 학습
python tunia_onprem.py train --epochs 2      # 예제는 2 에폭이면 충분 · 실제 문서는 기본(8)
python tunia_onprem.py train --device cpu    # GPU가 없을 때
  검수 LLM: 안 씀 — 기본 모델 판정 + 문서 표기(대외비 등)로 라벨해요. 문서는 이 PC를 떠나지 않아요.
  [status] labeling 20% — 직접 등급을 달아 주신 문서 43건은 그 등급을 정답으로 써요
  [status] split 48% — 학습 43건 / 귀사 시험 문제지 5건으로 준비했어요
  [status] training 62% — 학습 1/2 에폭 — 검증 정확도 81.8%
  [status] evaluating 78% — 새 모델을 평가용 문서로 검증하고 있어요
✓ 학습 완료 → runs/20260909-011500/model
  · 귀사 문서 기준 등급 정확도가 90% → 90%로 변했어요.
  · 민감등급(기밀 이상) 재현율: 100% → 100%.
  · 표준 검증셋에서 기본 모델과의 등급 일치율은 98%예요 (급격한 회귀 없음 확인용).
성적표 읽는 법: 「기본 모델 → 우리 모델」 순서예요. 오른쪽이 크면 좋아진 거예요. 「일반 문서 성능이 흔들려 균형 데이터를 늘려 다시 학습했어요」가 보여도 정상 — 안전장치가 일한 거예요.
pack — 올릴 패키지 만들기
python tunia_onprem.py pack
✓ 패키지 → runs/20260909-011500/tunia_model.zip  (3.4 MB)
  - adapter.safetensors  3,707,176 bytes
  - thresholds.json  229 bytes
  - report.json  3,404 bytes
  - manifest.json  315 bytes
  이 zip에 든 것: 어댑터 가중치(숫자) · 유형 문턱값 · 성적표(점수·건수만 — 파일 이름 없음). 문서 내용은 없어요.
upload — Tunia에 올리고 확인
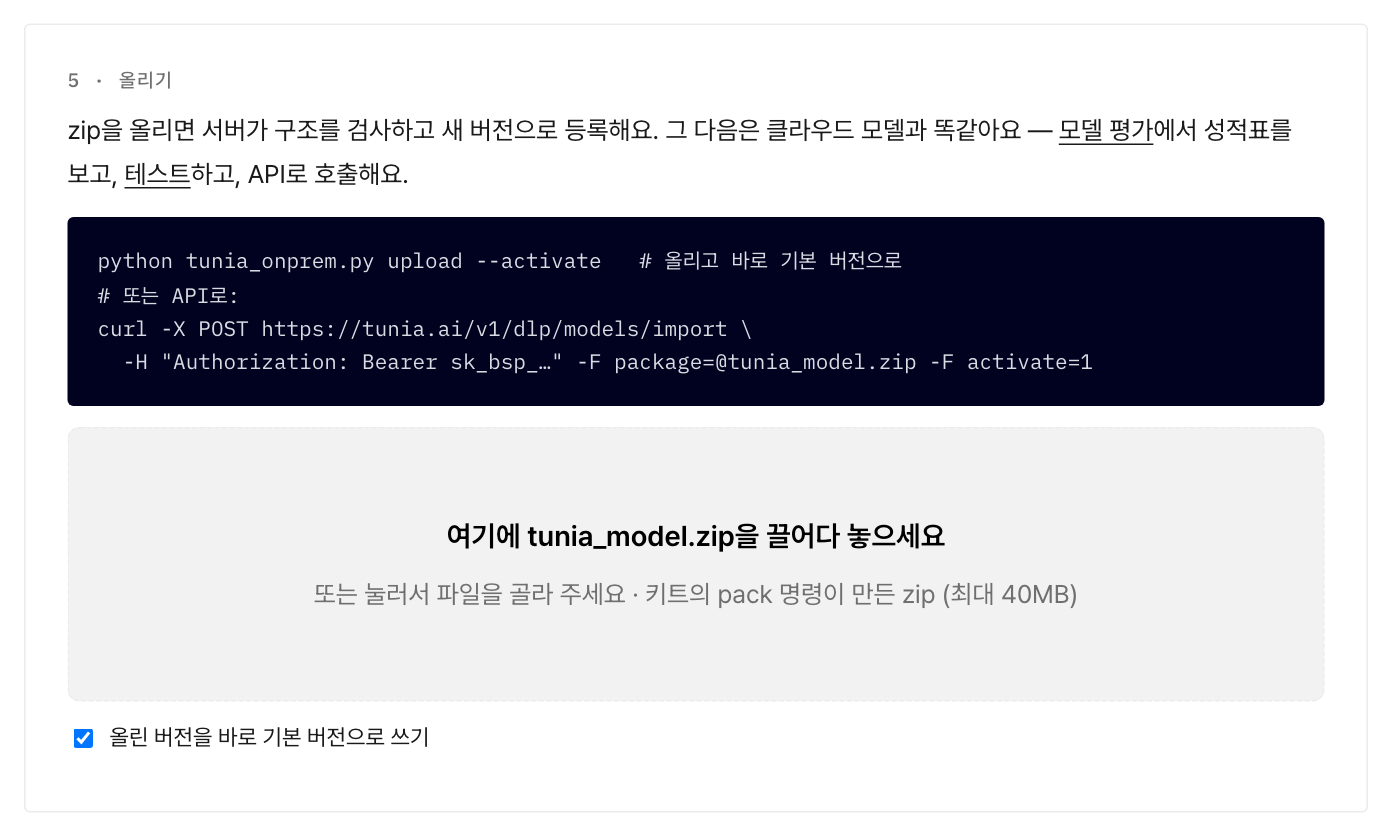
python tunia_onprem.py upload --activate # 올리고 바로 기본 버전으로
올리는 중 → https://tunia.ai  (3.4 MB)
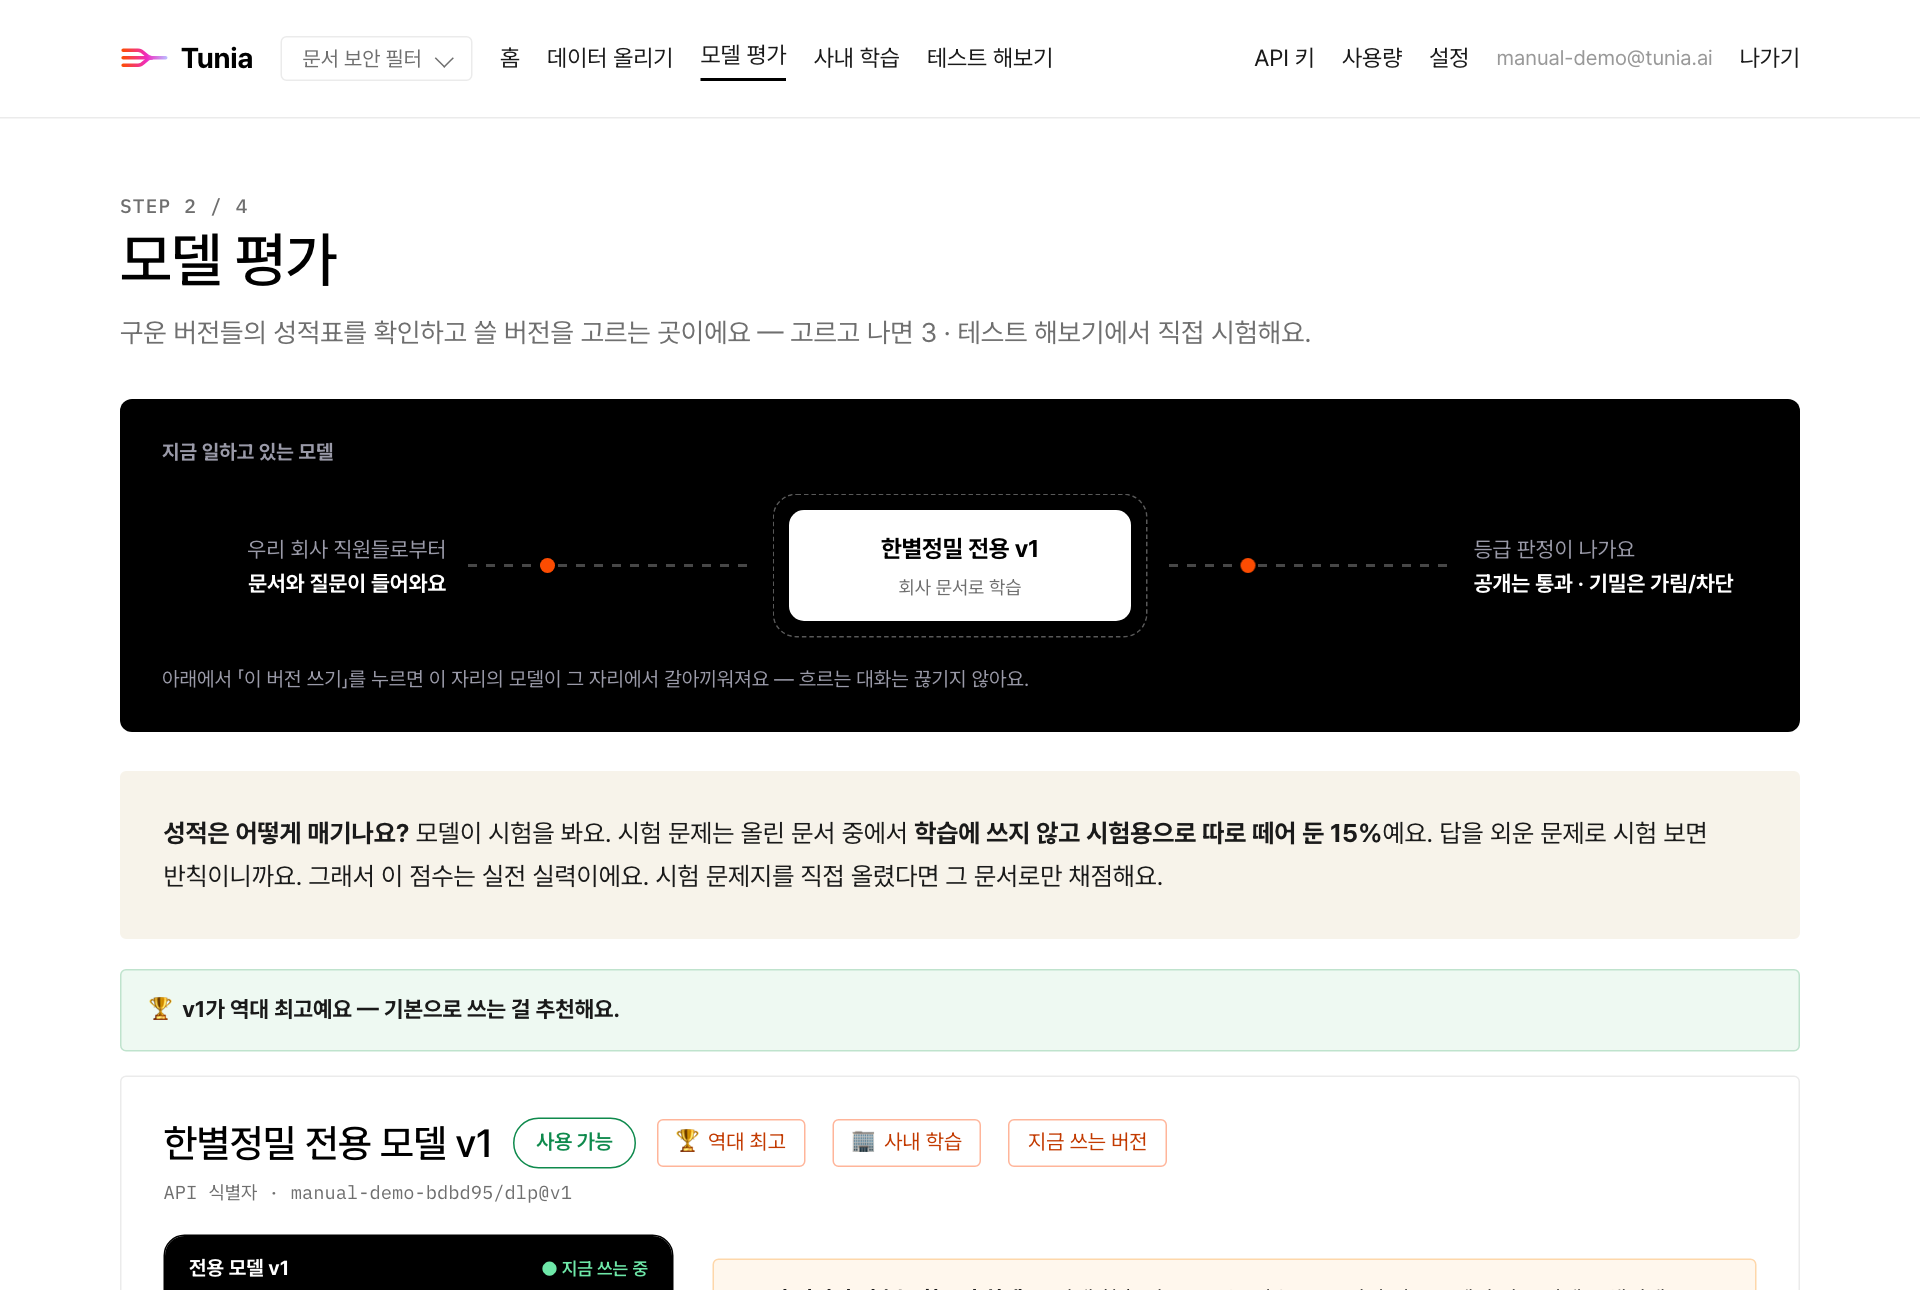
✓ 등록 완료: 우리회사/dlp@v1  (버전 1)
  이 버전이 기본 버전으로 지정됐어요 — API 호출이 바로 이 모델로 판정해요.
  확인: https://tunia.ai/app/models
인터넷이 없는 PC 라면 tunia_model.zip 을 USB로 옮겨 콘솔 사내 학습 화면 아래에 끌어다 놓아도 똑같아요.
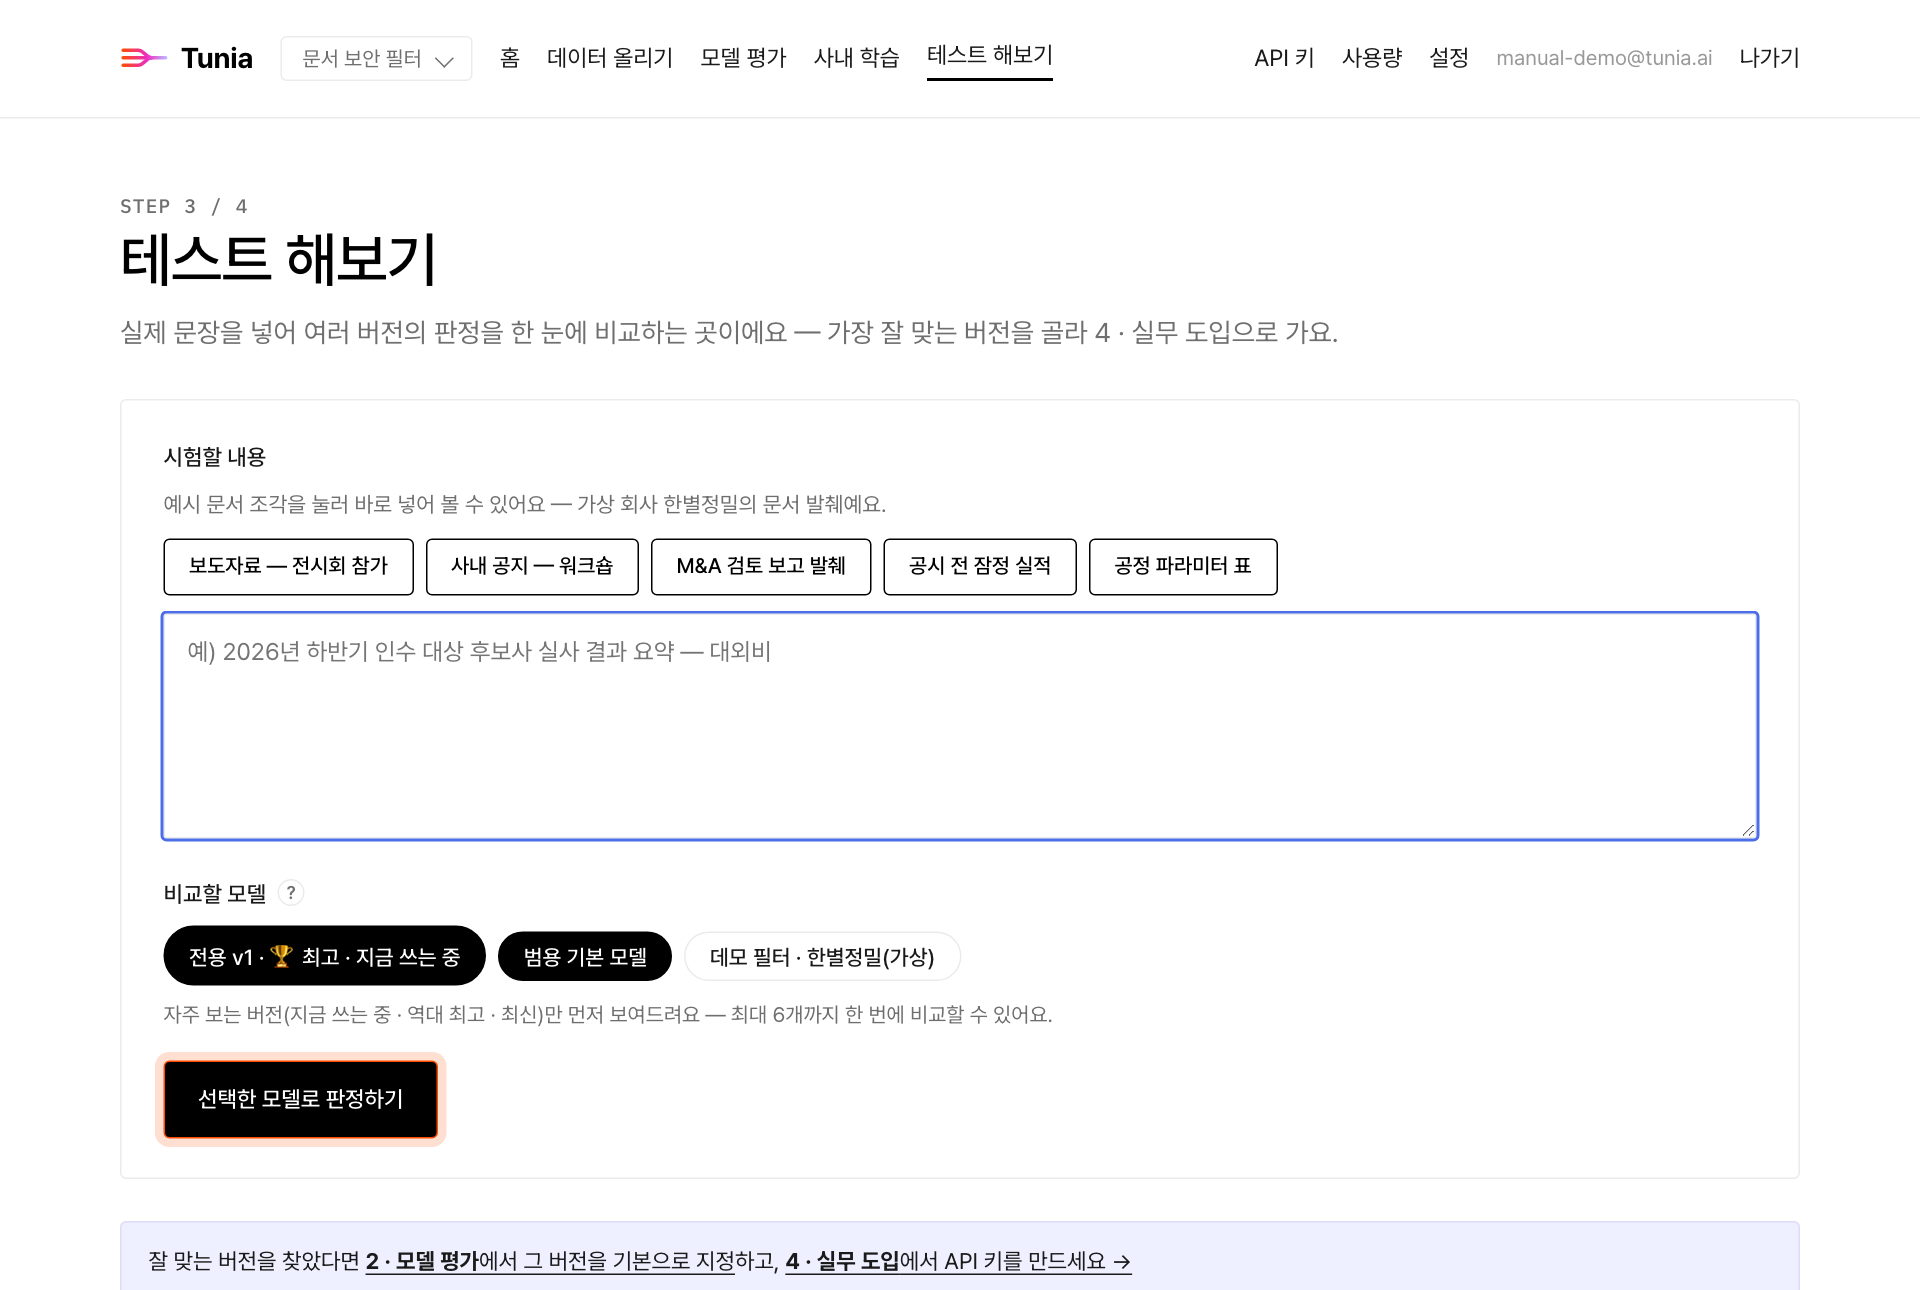
이제 우리 문서로 바꾸기
- 예제문서/학습문서/ 안의 예제 파일을 지우고, 같은 등급 폴더에 우리 문서를 넣어요.
- 등급을 아는 문서 → 해당 폴더 (공개·내부·기밀·제한·영업비밀·특급 · 영문 이름도 돼요)
- 등급을 모르는 문서 → 등급모름/ 같은 아무 이름 폴더 (자동 라벨)
- 표로 관리한다면 labels.csv(파일이름,등급)를 학습문서/ 에 두면 폴더 대신 그걸 써요
- 「꼭 잡아야 하는」 문서 몇 건은 시험문제지/ 의 등급 폴더에 → 성적표가 진짜 정답 기준으로 나와요
- 5~8장을 그대로 반복해요 (train 은 --epochs 없이 기본 8)
한 번에: python tunia_onprem.py all ./예제문서/학습문서 --activate
폐쇄망 · 더 정확하게 · 자주 겪는 문제
폐쇄망이라면
- 인터넷이 되는 PC에서 3~4장을 실행해 .venv/(또는 pip download -r requirements.txt -d wheels) · base/ · hf/ 를 만들어요
- 키트 폴더째 폐쇄망 서버로 옮겨요 (pip install --no-index --find-links wheels -r requirements.txt)
- 5~7장은 인터넷 없이 돌아요 · tunia_model.zip 만 밖으로 옮겨 8장(콘솔 끌어다 놓기)
더 정확하게
- 등급을 직접 달아 주세요 — 사람이 단 등급이 어떤 자동 라벨보다 정확해요 (9장)
- 사내 LLM 서버가 있다면 검수에 붙여요 — 문서가 그 서버까지만 가요:
python tunia_onprem.py train --teacher openai --teacher-base-url http://10.0.0.5:8000/v1 --teacher-model 모델이름 - 문서를 더, 골고루 — 기밀만 넣으면 모든 문서를 기밀로 봐요
자주 겪는 문제
| 증상 | 해결 |
|---|---|
| python3: command not found | 파이썬 3.10 이상 설치 (python.org · 맥은 brew install python) |
| pip install 이 오래 걸려요 | torch가 커요(수백 MB). 정상이에요 |
| 「--api-key 에 … sk_bsp_」 오류 | 1장에서 새 키를 만들어 복사 |
| 「내려받지 못했어요」 | 방화벽에서 tunia.ai HTTPS 허용 · 프록시면 HTTPS_PROXY 환경변수 |
| insufficient_data | 문서 20건 이상 · 200자 넘는 문서로 |
| CUDA out of memory | --batch 4 또는 --device cpu |
| HWP가 안 읽혀요 | 한컴오피스에서 HWPX 또는 PDF로 저장 |
| 스캔 PDF가 글자 0 | OCR로 텍스트를 뽑아 txt 로 |
| 올릴 때 「기본 모델 버전이 달라요」 | init --force 로 번들을 새로 받고 다시 학습 |
공공기관은 이렇게 — 공공 모드 (N2SF C·S·O)
국가·공공기관은 문서를 기밀(C)·민감(S)·공개(O) 3등급으로 나눠요(국가 망 보안체계 N2SF). 공공 모드는 5~6장과 명령이 같고 --public-sector 만 붙여요. 폴더 이름을 C·S·O로 읽고, 자동 라벨 기준도 정보공개법 비공개 사유·비밀 표지·개인정보 기준으로 바뀌고, 성적표에 3등급 점수가 따로 나와요.
예제문서_공공/
  학습문서/
    공개/   ← O · 보도자료·고시·공고·조례·공표 통계·누리집 안내
    민감/   ← S · 내부 행정문서·회의록·정책 검토·인사·예산 세부·민원 처리·개인정보 포함 문서
    기밀/   ← C · 비밀(Ⅰ·Ⅱ·Ⅲ급)·대외비 표지, 국가 안보·수사·국민 안전·기반시설 보안 정보
  시험문제지/  (같은 구조 · 채점 전용)
python tunia_onprem.py parse ./예제문서_공공/학습문서 --public-sector
python tunia_onprem.py parse ./예제문서_공공/시험문제지 --test --public-sector
python tunia_onprem.py train --public-sector --epochs 2
python tunia_onprem.py pack
python tunia_onprem.py upload --activate
  공공 모드: 폴더 이름을 N2SF C·S·O(기밀·민감·공개)로 읽어요. 학습도 --public-sector 로 돌려 주세요.
✓ 문서 20/20건 → data/train.jsonl  (약 20쪽)
  직접 단 등급 20건 → 학습 때 정답으로 우선 써요 (C(기밀) 4 · S(민감) 9 · O(공개) 7)
  …
  공공 모드(N2SF): 라벨 기준은 C·S·O(기밀·민감·공개) · 성적표에 3등급 정확도가 함께 나와요.
✓ 학습 완료
  · [공공 모드] C·S·O 3등급 정확도가 …% → …%로 변했어요.
  · [공공 모드] 기밀(C) 문서를 C로 정확히 잡는 비율: …% → …%.
우리 기관 문서로 바꾸기: 9장과 같아요 — 예제문서_공공/학습문서/ 안의 파일만 우리 기관 문서로 바꿔 넣어요. 콘솔 설정의 공공기관 모드도 켜 두면 클라우드 업로드·API 응답도 같은 기준으로 맞춰져요.