문서는 한 장도
회사 밖으로 나가지 않아요.
보안 규정상 문서를 외부로 보낼 수 없는 회사가 있어요. 그래서 학습을 회사 안으로 보냈어요 — 문서는 그대로 두고 AI가 회사로 들어가요. 학습은 사내 PC·서버에서 하고, Tunia로 올라가는 것은 회사 기준을 담은 전용 학습 결과 하나예요. 판정력은 Tunia의 대형 기본 모델이 맡고, 그 위에 이 결과를 얹어 클라우드 모델과 똑같이 API 서빙을 받아요.
담장 안에서 다 하고,
관문을 넘는 건 결과 하나.
왼쪽은 전부 귀사 PC·서버 안에서 일어나요. 가운데 관문에서 Tunia 서버가 파일 구조를 검사하고, 오른쪽은 클라우드 모델과 완전히 같은 길이에요.
- 문서 읽기워드·PPT·엑셀·HWPX·PDF에서 글만 뽑아요
- 등급 정하기폴더 이름으로 직접 달거나, 기본 모델이 자동으로
- 학습대형 기본 모델 위에 회사 기준을 배워요 · GPU 5~10분
- 성적표학습에 안 쓴 문서로 채점 · 회귀 안전장치
- 새 버전 등록「🏢 사내 학습」 표식이 붙어요
- 서빙기본 모델에 전용 결과를 끼워 판정 · 수 ms
- API · 플레이그라운드연동 코드는 클라우드 모델과 동일
- 성적표 보기모델 평가에서 점수 확인 · 버전 갈아끼우기
✓ 패키지 → runs/20260909-011500/tunia_model.zip
  - adapter.safetensors   전용 학습 결과 (숫자 배열)
  - thresholds.json       유형 판정 문턱값 (숫자 11개)
  - report.json           성적표 (점수·건수만 — 파일 이름 없음)
  - manifest.json         기본 모델 버전 · 학습 시각 · 해시
  이 zip에 든 것이 회사 밖으로 나가는 전부예요. 문서 내용은 없어요.
보안팀에는 이 네 줄을 그대로 보여 주면 돼요. 파일 하나하나 열어서 확인할 수도 있어요 — 전부 사람이 읽을 수 있는 숫자와 JSON이에요.
보안 실사 질문지에
이렇게 답하면 돼요.
도입 검토에서 실제로 나오는 질문을 모았어요. 그대로 복사해 회신해도 되게 썼어요.
없어요. 문서 읽기·라벨·학습·채점이 전부 귀사 장비에서 끝나요. 외부로 가는 HTTPS 요청은 기본 모델 번들 내려받기(1회)와 결과 zip 올리기, 두 번이에요.
없어요. 분류 전용 모델의 회사 전용 부분(어댑터)이라 출력이 「등급 하나」뿐이고, 문서 내용을 담을 자리가 없어요. 파일은 사람이 열어 볼 수 있는 숫자 배열과 JSON이에요.
기본은 안 써요. 사내 LLM 서버가 있으면 그것을 붙일 수 있고(문서가 그 서버까지만), 외부 LLM은 명시적으로 옵션을 켜야만 동작해요.
돼요. 인터넷이 되는 PC에서 키트·번들·인코더를 받아 폴더째 옮기면 그 뒤로는 인터넷이 필요 없어요. 결과 zip은 USB로 옮겨 콘솔에 올려도 돼요.
국내 리전의 격리된 저장소에 회사별로 보관되고, 판정 때 서빙 서버가 불러 써요. 회사 간 공유는 없고, 삭제 요청 시 바로 지워요.
귀사 이름으로 발급되고 귀사 전용 모델을 만드는 용도로만 써요. 번들 안 LICENSE.txt 에 그대로 적혀 있어요.
답변을 생성하는 AI가 아니라,
등급만 판정하는 AI입니다.
챗봇형 모델은 학습한 문장을 되뱉을 수 있어요. Tunia의 모델은 어떤 입력을 넣어도 출력이 「공개~특급 중 하나」뿐인 분류기예요. 판정력의 몸통은 Tunia가 대규모 문서로 미리 학습해 둔 대형 기본 모델이고, 올라가는 것은 그 위에 얹는 회사 전용 학습 결과(어댑터)예요 — 그것만으로는 아무 판정도 못 하고, 문서 내용은 애초에 들어 있지 않아요.
등급 하나
문장을 생성하는 경로가 없어요. 유출될 출구 자체가 없는 구조예요.
대형 기본 모델 + 전용 결과
무거운 판정력은 기본 모델이, 회사 기준은 전용 학습 결과가 맡아요. 나가는 파일은 문서 수백 건이 들어갈 수 없을 만큼 작아 유출 자체가 성립하지 않아요.
구조만 받아요
서버는 정해진 모양의 숫자 배열(safetensors)만 받고, 실행 코드가 섞일 수 있는 형식은 거절해요.
기관 문서는 기관 안에서만 학습하고,
판정은 C·S·O로 바로 나와요.
국가 망 보안체계(N2SF)가 요구하는 기밀(C)·민감(S)·공개(O) 분류를, 범용 규칙이 아니라 우리 기관 문서의 맥락으로 배운 맞춤형 가드레일이 해요. 학습은 사내 학습 키트의 공공 모드로 기관 안에서만 — 비공개 문서가 밖으로 나갈 일이 없어요.
기밀
보안업무규정상 비밀(Ⅰ·Ⅱ·Ⅲ급)·대외비 표지, 국가 안보·수사·국민 안전·기반시설 보안 정보. 판정 즉시 차단 정책과 연결.
민감
정보공개법 제9조 비공개 사유 — 내부 행정문서·정책 검토·인사·예산 세부·민원 처리·개인정보 포함 문서. 공공 업무 문서의 대부분.
공개
보도자료·고시·공고·조례·공표 통계·누리집 안내. 과차단 없이 업무 속도를 지켜요.
- 폴더 이름이 C·S·O. 공개/ 민감/ 기밀/(또는 O/S/C)로 나눠 두면 그 등급이 정답이에요 — 기관이 이미 아는 등급을 그대로 써요.
- 라벨 기준이 N2SF. 자동 라벨도 정보공개법 비공개 사유·비밀 표지·개인정보 기준으로 판단해요.
- 성적표가 3등급. C·S·O 정확도, 기밀(C)을 놓치지 않는 비율, 공개(O)를 잘못 막은 비율이 따로 나와요.
- 판정에 C·S·O가 항상. 응답의 n2sf 필드만 보고 C=차단·S=제한·O=허용으로 배선하면 끝.
python tunia_onprem.py parse ./기관문서 --public-sector
python tunia_onprem.py train --public-sector
python tunia_onprem.py pack && python tunia_onprem.py upload --activate
키트에 가상 기관 「한별시」 예제 문서 29건(공개·민감·기밀 폴더)이 들어 있어요 — 그대로 한 번 돌려 보고 파일만 바꾸면 돼요. 공공 모드 매뉴얼 →
클라우드 학습과 사내 학습,
그리고 설치형과의 차이.
보안 요건에 따라 고르면 돼요. 사내 학습은 「설치형의 보안」과 「클라우드의 운영 편의」를 같이 가져가요.
| 클라우드 학습 | 사내 학습 | 설치형(온프레미스 전체) | |
|---|---|---|---|
| 문서가 회사 밖으로 | 나가요 (암호화·즉시 삭제) | 안 나가요 | 안 나가요 |
| 학습 장비 | Tunia 국내 GPU | 사내 PC·서버 (GPU 권장 · CPU 가능) | 사내 GPU 서버 필수 |
| 서빙·운영 | Tunia가 해요 | Tunia가 해요 — 학습 결과만 올리면 끝 | 회사가 직접 (설치·업데이트·장애 대응) |
| 공공기관 N2SF | 공공 모드 지원 | 공공 모드 지원 — C·S·O 폴더·3등급 성적표 · 문서는 기관 안에 | 회사 몫 |
| 라벨 검수 | 전문가 모델 자동 검수 | 기본 없음 · 사내 LLM 연결 가능 · 직접 단 등급은 정답으로 | 회사 몫 |
| 시작까지 | 10분 | 1시간 안 (키트 설치 포함) | 수 주 (장비·계약·설치) |
| 비용 | 학습 49,000원 · 호출 30원 | 학습 무료(귀사 장비) · 호출 30원 | 별도 견적 |
등급을 몰라도 시작하고,
알면 알려 주세요.
문서마다 등급을 미리 달 필요는 없어요 — 기본 모델 판정과 문서 안 표기(「대외비」 등)로 자동 라벨을 만들어요. 다만 회사가 이미 아는 등급은 사람이 단 것이 가장 정확해서, 폴더로 나누기만 하면 그 등급을 정답으로 우선 써요.
자동 라벨
기본 모델이 1차 분류하고 문서 표기로 보정해요. 등급이 골고루 섞여 있으면 이것만으로도 경계를 배워요.
공개/ 내부/ 기밀/ 제한/ 영업비밀/ 특급/
폴더 이름이 곧 정답이에요. 일부만 나눠도 되고, 나머지는 자동. 시험 문제지도 폴더로 나누면 성적표가 진짜 정답 기준으로 나와요.
labels.csv
「파일이름,등급」 두 칸짜리 표. 문서관리시스템에서 뽑아 둔 등급 목록이 있으면 그대로 써요.
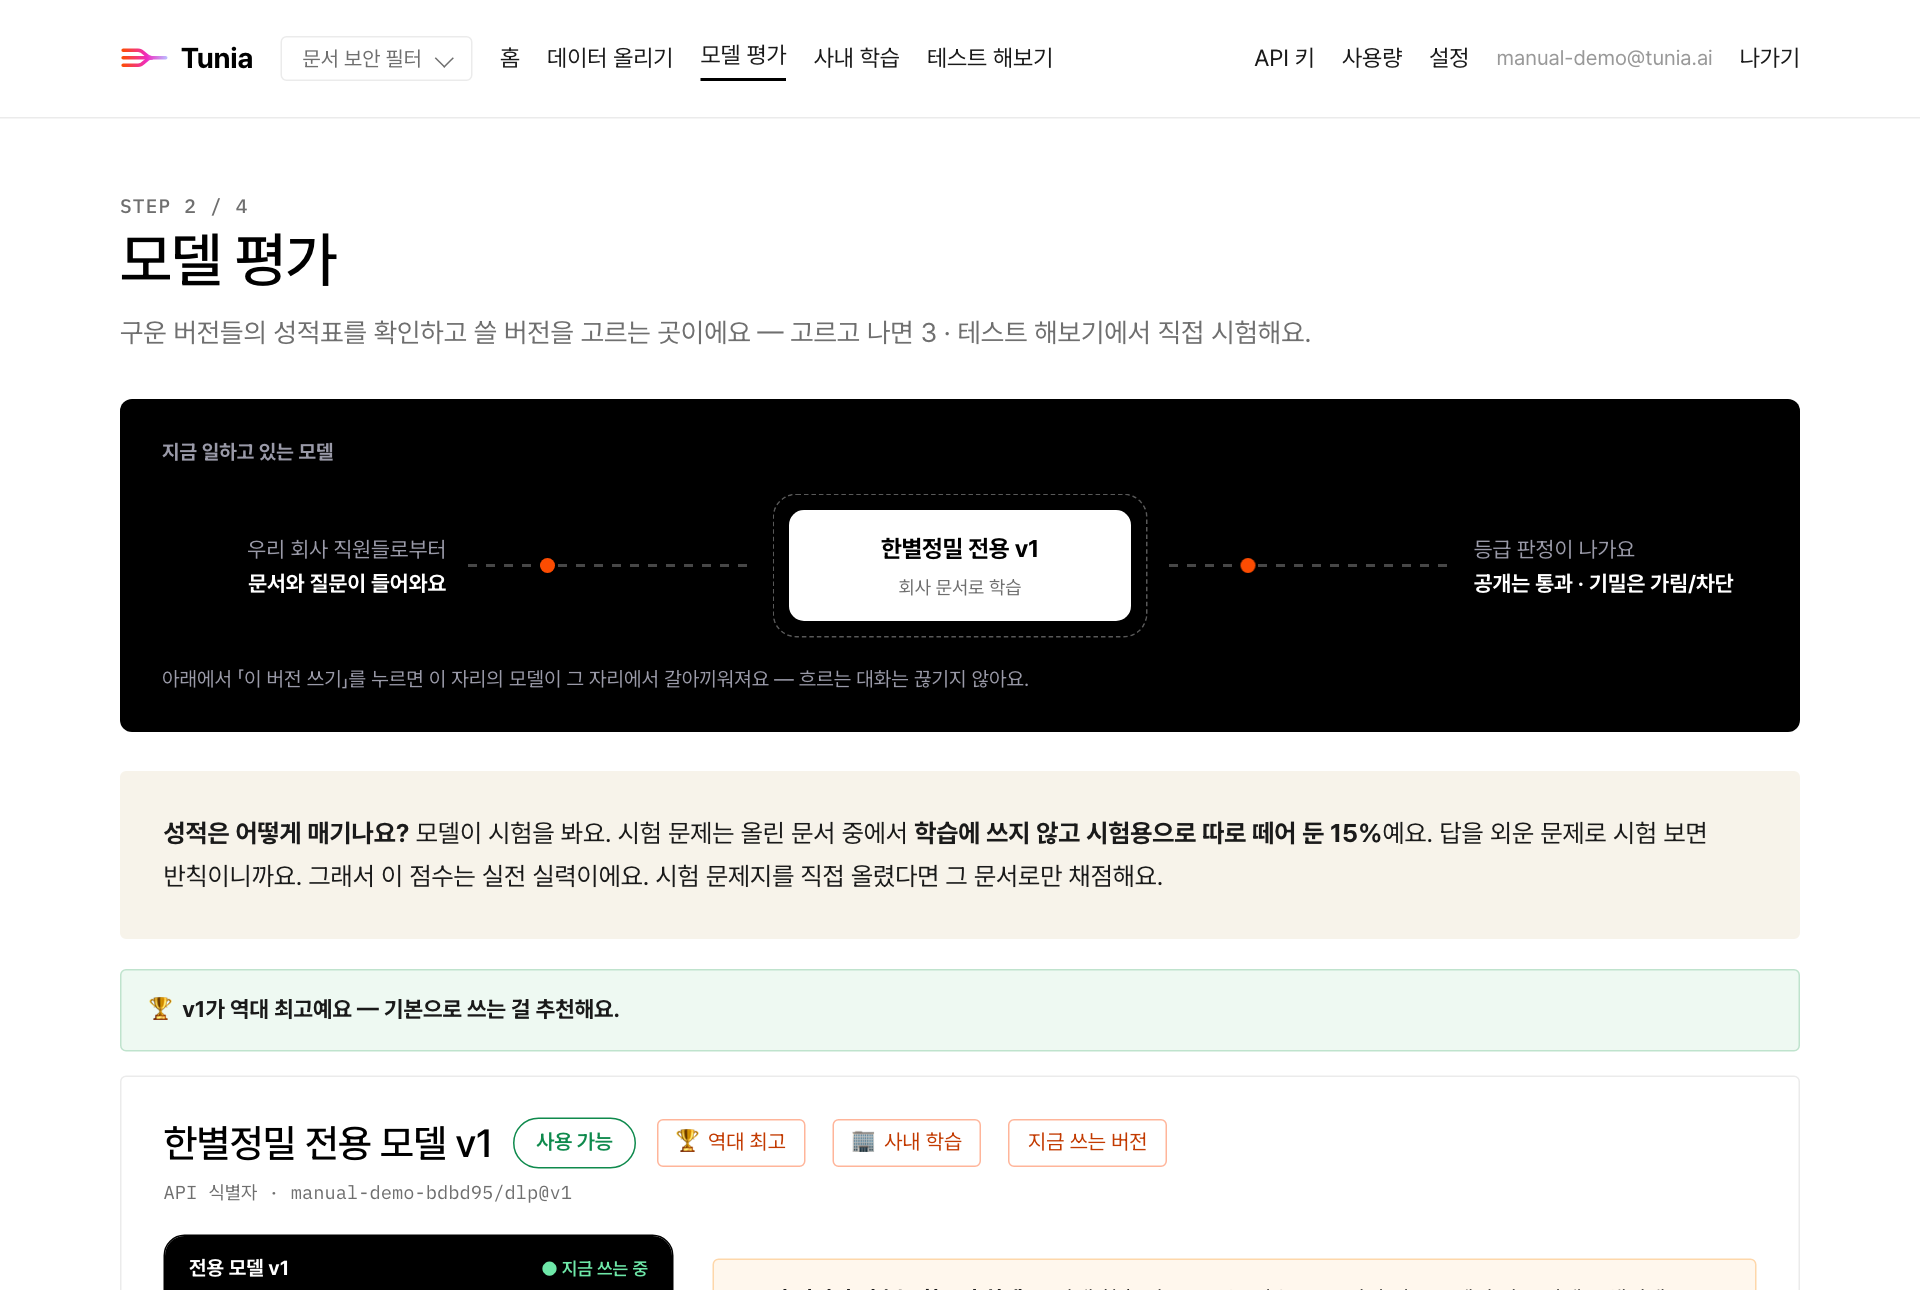
사내에서 구운 모델도
콘솔에서는 똑같이 다뤄요.
「🏢 사내 학습」 표식만 다르고, 성적표·버전 갈아끼우기·테스트·API 키까지 클라우드 모델과 같은 화면이에요.
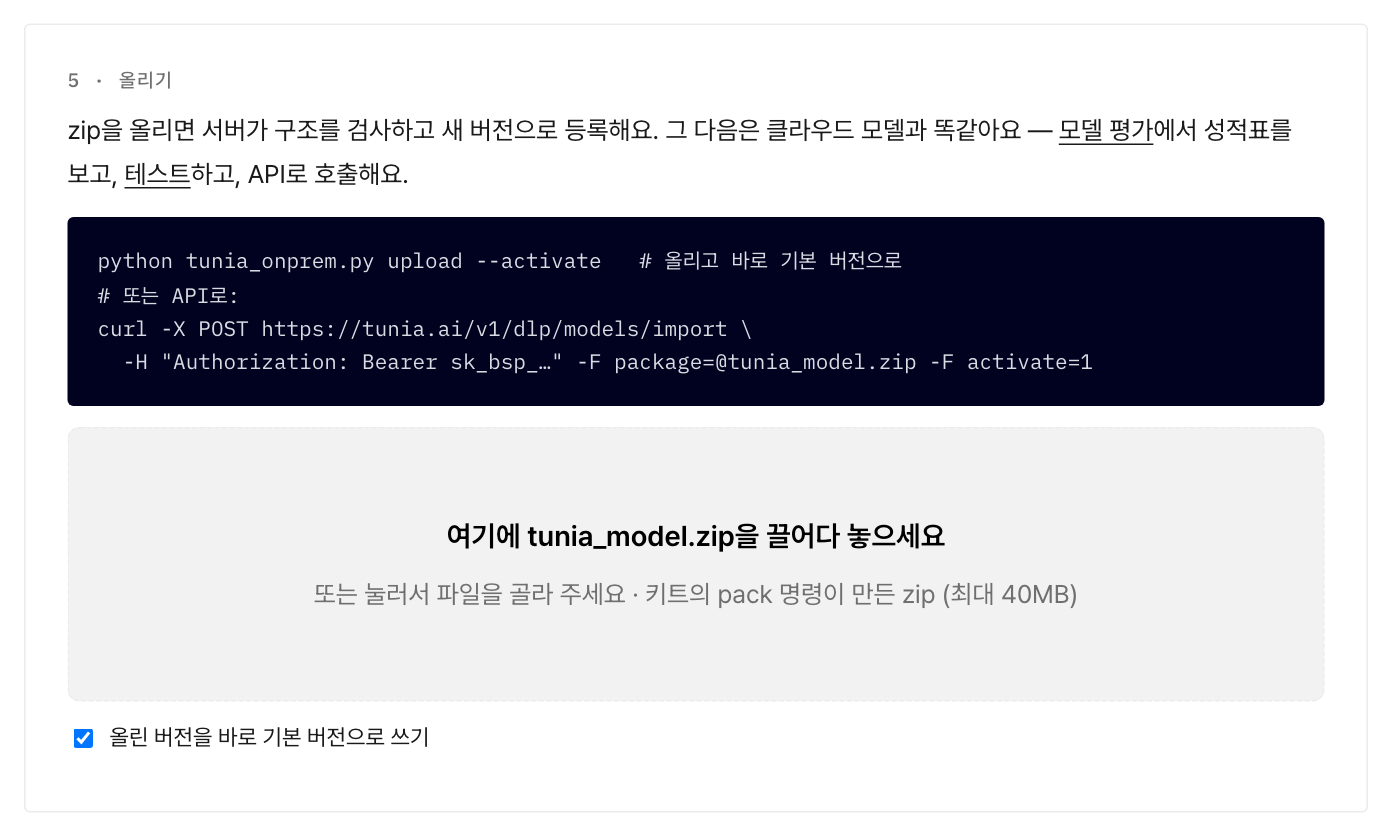
개발자 한 명이 한 시간이면 끝나요.
키트는 파이썬 스크립트 하나예요. 인터넷이 없는 폐쇄망이면 인터넷 되는 PC에서 1단계만 하고 폴더째 옮기면 돼요.
자주 묻는 질문
올라간 학습 결과로 우리 문서를 복원할 수 있나요?
없어요. 분류 전용 모델의 회사 전용 부분(어댑터)이라 어떤 입력을 넣어도 출력은 「공개~특급 중 하나」뿐이고, 문서 내용을 담을 자리도 없어요.
클라우드 학습보다 성능이 떨어지지 않나요?
같은 학습 코드·같은 기본 모델이에요. 기본 모드는 라벨 검수 LLM을 생략하니 그만큼 차이가 날 수 있고, 두 가지로 메울 수 있어요 — 사내 LLM 서버를 검수에 붙이거나, 아는 등급을 폴더로 나눠 정답을 직접 주는 것. 사람이 단 등급은 어떤 자동 라벨보다 정확해요.
GPU가 없어도 되나요?
돼요. CPU는 문서 500건 기준 30분에서 1시간쯤 걸려요. GPU가 있으면 5~10분이에요.
폐쇄망인데요?
인터넷이 되는 PC에서 키트·번들·언어 인코더를 받아 폴더째 옮기면 그 뒤로는 인터넷이 필요 없어요. 완성된 zip은 USB로 옮겨 콘솔에 끌어다 놓아도 돼요.
비용은요?
모델 올리기는 무료예요(학습은 귀사 장비에서 하니까요). 판정 API 호출은 클라우드 모델과 같이 건당 30원이에요.